


ヒューマノイドの全身制御を扱っていると、接触を含む全身の軌道が手元で何秒で出るのかは、仮説を何回試せるかに直結します。その軌道が、24コアのノートPCのCPUだけで解けました。対象はUnitree G1のバックフリップで、モーションキャプチャで撮られたバックフリップを関節の対応づけでG1に移し替え、それを追いかける軌道です。かかった時間は27.2秒で、使ったのは、MuJoCoをCPUで並列に実行するライブラリ kevinzakka/mjbatch です。
この記事でわかること
- ソルバが出した「バックフリップの計画」が、物理として本当に一回転しているかを確かめる手順
- 最適化が出した数字のうち、どれを測定として読めて、どれを読めないのか
- MuJoCoで接触力を計測するとき、エラーも警告もなく0 Nが返ってくる条件と、その回避方法
- CPU上でMuJoCoをバッチ実行したとき、スレッド数とサブステップ数でスループットがどこまで伸びるか
mjbatchとは — GILを解放したCPUスレッドプールで回すMuJoCo
mjbatchは、CPU上でMuJoCoのシミュレーションを数千本並列に進めるPythonライブラリです。READMEが挙げる機能は3つで、GILを解放したC++のスレッドプールで実行すること、バッチ全体の状態と制御に bind で配列として触れること、そして expand でシミュレーションごとに異なるモデルパラメータを持てることです。
アルゴリズムは利用者の側にあり、mjbatchが受け持つのは、多数のシミュレーションを並列に進める部分だけです。
import mujoco, numpy as np
from mjbatch import Batch

model = mujoco.MjModel.from_xml_path("scene.xml")
batch = Batch(model, num_sims=4096)  # threads default to every logical CPU
qpos, ctrl = batch.bind("qpos"), batch.bind("ctrl")
batch.expand("geom_friction")[:, :, 0] = np.random.uniform(0.4, 1.2, (4096, 1))
for _ in range(1000):
  ctrl[:] = policy(qpos)             # your controller, all 4096 at once
  batch.step()                       # step them in parallel; qpos updates in place
サンプルは6本あり、最適制御から強化学習、機体設計の最適化までを、それぞれ1ファイルで実装しています。ここで扱うのは、Unitree G1のバックフリップを反復的な最適制御で追従する例です。
並列にMuJoCoを回すなら、GPUでいいのではないか。実際、その側の実装のほうが先にあり、JAX/XLAでGPUやTPUにコンパイルするMJXと、NVIDIA Warpの上に実装されたMuJoCo Warpがそれにあたります。後者のドキュメントは狙いを「スループット、すなわち単位時間あたりの総シミュレーションステップ数」に置いたと書き、READMEのほうは、高速なシミュレーションにはNVIDIAのGPUが必要で、CPUは開発とデバッグのためにサポートしていると断っています。GPU側の実装にとって、CPUは開発用の足場です。
mjbatchはその足場の側で、同じスループットを狙いますが、GPUではなくCPUを選んだ理由は、READMEには書かれていません。作者のKevin Zakka氏はMuJoCo Menagerieを手がけており、MuJoCo Warpの上に載るGPU向けのmjlabも並行して公開しています。CPU向けとGPU向けが同じ作者から並んで出ている状況なので、手元で測れるのは選択の理由ではなく、CPUだけで何がどこまでできるかのほうです。
検証環境
項目 | 値 |
|---|---|
CPU | Intel Core Ultra 9 275HX(24論理コア) |
OS | Ubuntu 22.04.5 LTS |
ツールチェーン | cmake 3.22.1 / gcc 12.3.0 |
Python | 3.13 |
mujoco | 3.11.0 |
以下の計画も測定も、GPUは使いません。
セットアップ
手順 | 実時間と備考 |
|---|---|
uv sync --group dev | 9.0秒 — nanobind/C++拡張をソースからビルド |
uv run pytest | 0.7秒 — 39件すべて成功 |
uv sync --group examples | 54秒 — ほぼtorchのダウンロード待ち |
G1のバックフリップを解く
examples/g1_flip.py が求めるのは、参照のクリップを追いかける制御列です。各時刻のまわりで運動方程式を線形近似し、二次のコストを最小化する制御列を反復で解き直すこの解法を、iLQRと呼びます。解くのは先の有限区間(ホライズン)についてだけで、先頭だけを実行して窓を前にずらしながら解き直す使い方が、receding horizonです。線形近似の係数は有限差分で取るので、先を見る50ステップ分について、各時刻(ノット)ごとに状態と制御の成分を1つずつ揺らしたシミュレーションが要り、これだけで数千本になります。
その数千本を1つのバッチに詰めて batch.step() の呼び出し1回で進めるのが、mjbatchがここで担う部分です。ステップ幅を9通り試すラインサーチも、同じバッチの中でシミュレーションとして実行されます。
対象のモデルは、mjbatchが同梱する簡略版のG1です。MuJoCo Menagerieの29関節モデルから両手首の3関節ずつを省いた23関節版であり、トルク制御のアクチュエータも23個です。胴体そのものが床に固定されていないので、その並進3と回転3も自由度に数えて、速度自由度は29になります。実機にも可動関節23個の構成があります。
env -u PYTHONPATH uv run examples/g1_flip.py --headless接触を含む全身のバックフリップが、ノートPCの上で27.2秒で計画できました。このときのCPU使用率は523%、最終コストは276.3で、2回の実行では27.2秒と28.3秒、最終コストはどちらも276.3で一致しました。
24コアあるのに523%、つまり5コア分しか埋まっていませんが、窓ごとのバッチはさきほどの数千本なので、バッチが狭いせいではありません。5コア分にとどまるのは、並列に回せるのが線形化の区間だけで、窓ごとの後退パスとPython側の処理が直列に残るからだと見ていますが、内訳までは測っていません。言えるのは、27.2秒がライブラリの上限ではないことです。
ソルブの進み方はログに残っています。コストは単調に下がらず、途中で最終値の50倍近くまで跳ね上がるので、最初は発散したのかと思いました。骨盤の高さを併記すると、そうではないとわかります。立っているときが0.77 mであるのに対し、コストが最大になるあたりでは1.03 mまで上がっており、宙返りと着地は参照の動きがいちばん速いので、追従の残差もそこで最大になります。窓がその区間を通過すると、コストは下がります。
計画されたものが本当にバックフリップかを測る
計画コストは物理ではありません。276.3という数字が示すのは、ソルバが自分の目的関数をどこまで下げたかであって、ロボットが回ったかどうかではないので、測りたいのは回転角や滞空時間のような物理量のほうです。
そこで計測用のツールを書き、保存された計画を1本のシミュレーションに閉ループで流し込みました。状態が計画からずれたらその場でトルクを補正する、サンプル自身の再生ループと同じフィードバック則であり、追従器もフィードバック則も、サンプル側からそのまま読み込んでいます。
from g1_flip import Clip, Tracker, build_model, quat_log, quat_mul測定項目 | 値 |
|---|---|
胴体の正味回転 | −359.4°(ピッチ軸まわり、負が後方回転) |
滞空時間(接触なし) | 0.620秒 |
弾道からの逆算 | 0.650秒(計測値との差4.6%) |
関節トルクの最大 | 右膝 121 Nm(上限139 Nmの87%) |
トルク上限に張り付いたアクチュエータ | 23個中7個 |
床反力の鉛直成分の最大 | 3.3 kN=体重の10.0倍 |
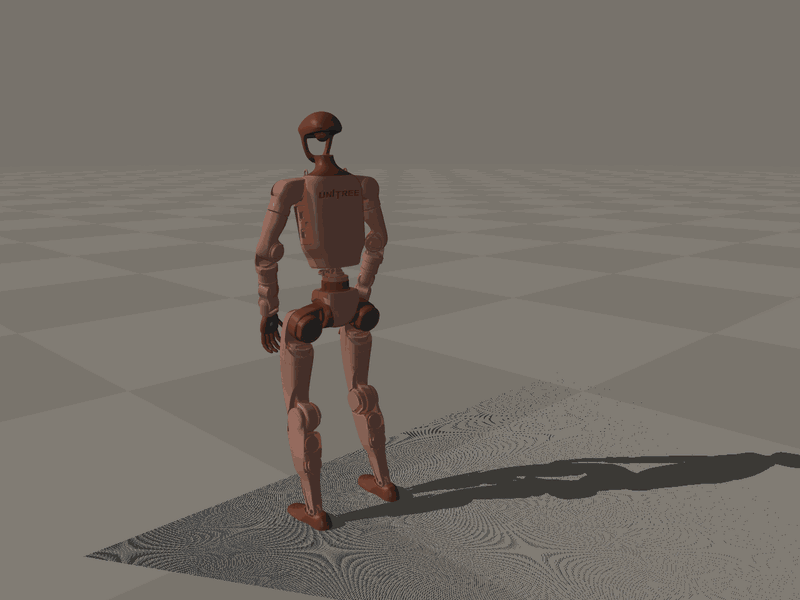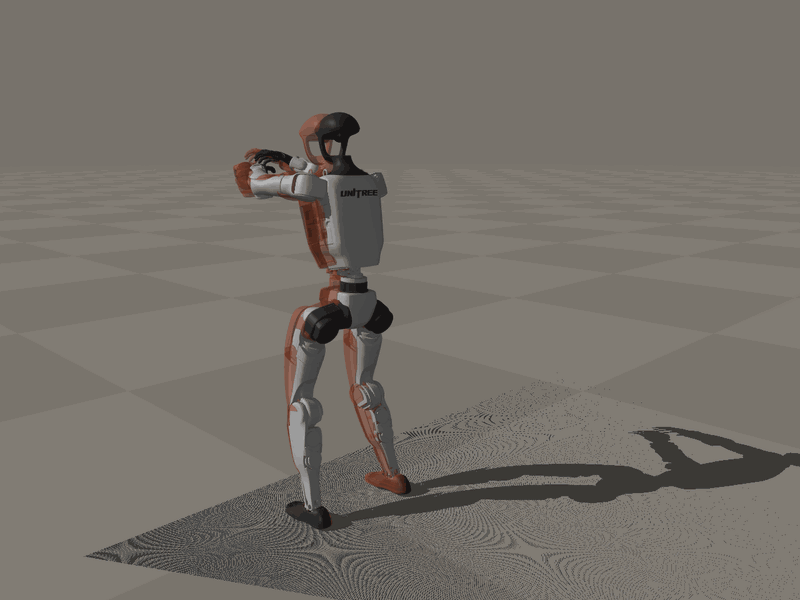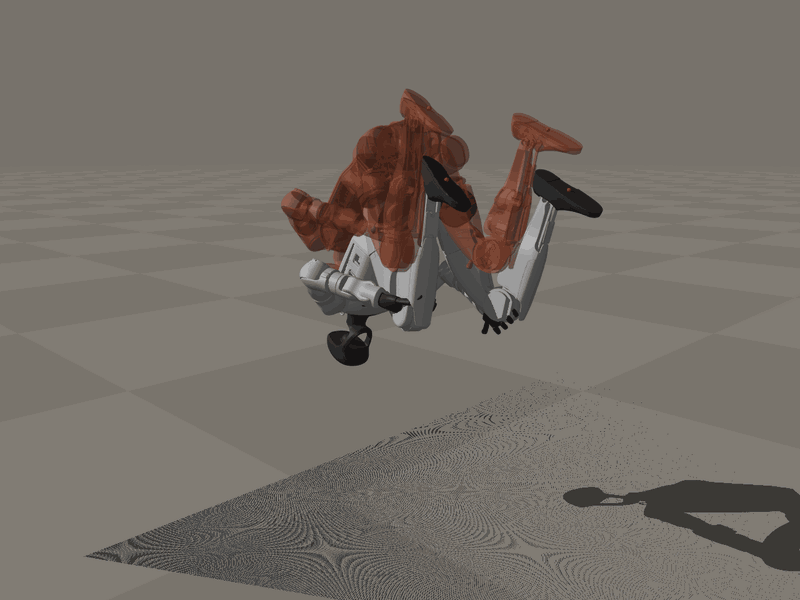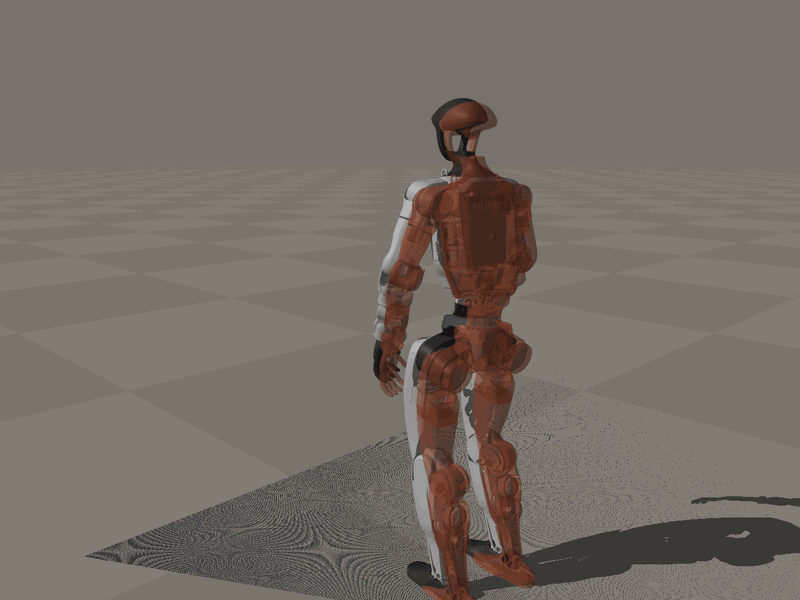
胴体は360°に0.6°足りないだけ回っており、コストが下がっただけの転倒であれば、この値は出ません。
滞空時間の行は、独立した検証になっています。離地のときの鉛直速度だけを使い、あとは重力しかかからないと仮定して滞空時間を逆算すると、接触の有無から測った値と4.6%しか違いません。目安として、離地と着地の判定が10 ms刻みであることだけで両端で3%ほどは動くので、4.6%はその程度の大きさです。しかもこの逆算には接触モデルが一切入らないので、飛行中の軌道が接触ソルバの副産物ではなく、素直な弾道になっていることの傍証になります。
ただし、素直に受け取れない数字が2つ混じっています。
床反力の行がその1つです。体重の10倍、33 kgのモデルに対して約3.3 kNという値は、接触を硬い拘束ではなくばねとダンパで近似するMuJoCoの接触モデル(ソフトコンタクト)が出したものであって、フォースプレートの計測ではありません。接触モデルの取り方も、ソルバの剛性も、10 msという刻み幅も、すべてこの値に入ります。なかでも刻み幅は、MuJoCoの既定値0.002秒の5倍で、接触を扱うには粗いほうです。
ばねの硬さは、逆向きの計算からわかります。同じモデルの逆動力学に数ミリの足のめり込みを渡すと数十kNという値が出るので、3.3 kNという値も同じ硬さの上に出ており、実機の予測として読むわけにはいきません。
もう1つは、制御が上限に張り付いている点です。23個のアクチュエータのうち7個(両股のピッチ、両足首のピッチ、腰のピッチ、両肩のピッチ)が、ピーク時にトルク上限をちょうど100%使い切っています。上限は関節ごとに違い、股のピッチが88 Nm、足首と腰のピッチが50 Nm、肩のピッチが25 Nmですが、膝だけは139 Nmと高く、張り付いた7個には入っていません。
最大のトルクを出しているのはその右膝で、121 Nm、上限の87%であり、絶対値が最大の関節と、上限に対する割合が最大の関節は別、ということになります。この計画は、モデル化されたG1にできることの限界ぎりぎりです。追従誤差を最小にする目的関数のもとでは、解が上限に達するのは当然ですが、モデル誤差に対する余裕はありません。
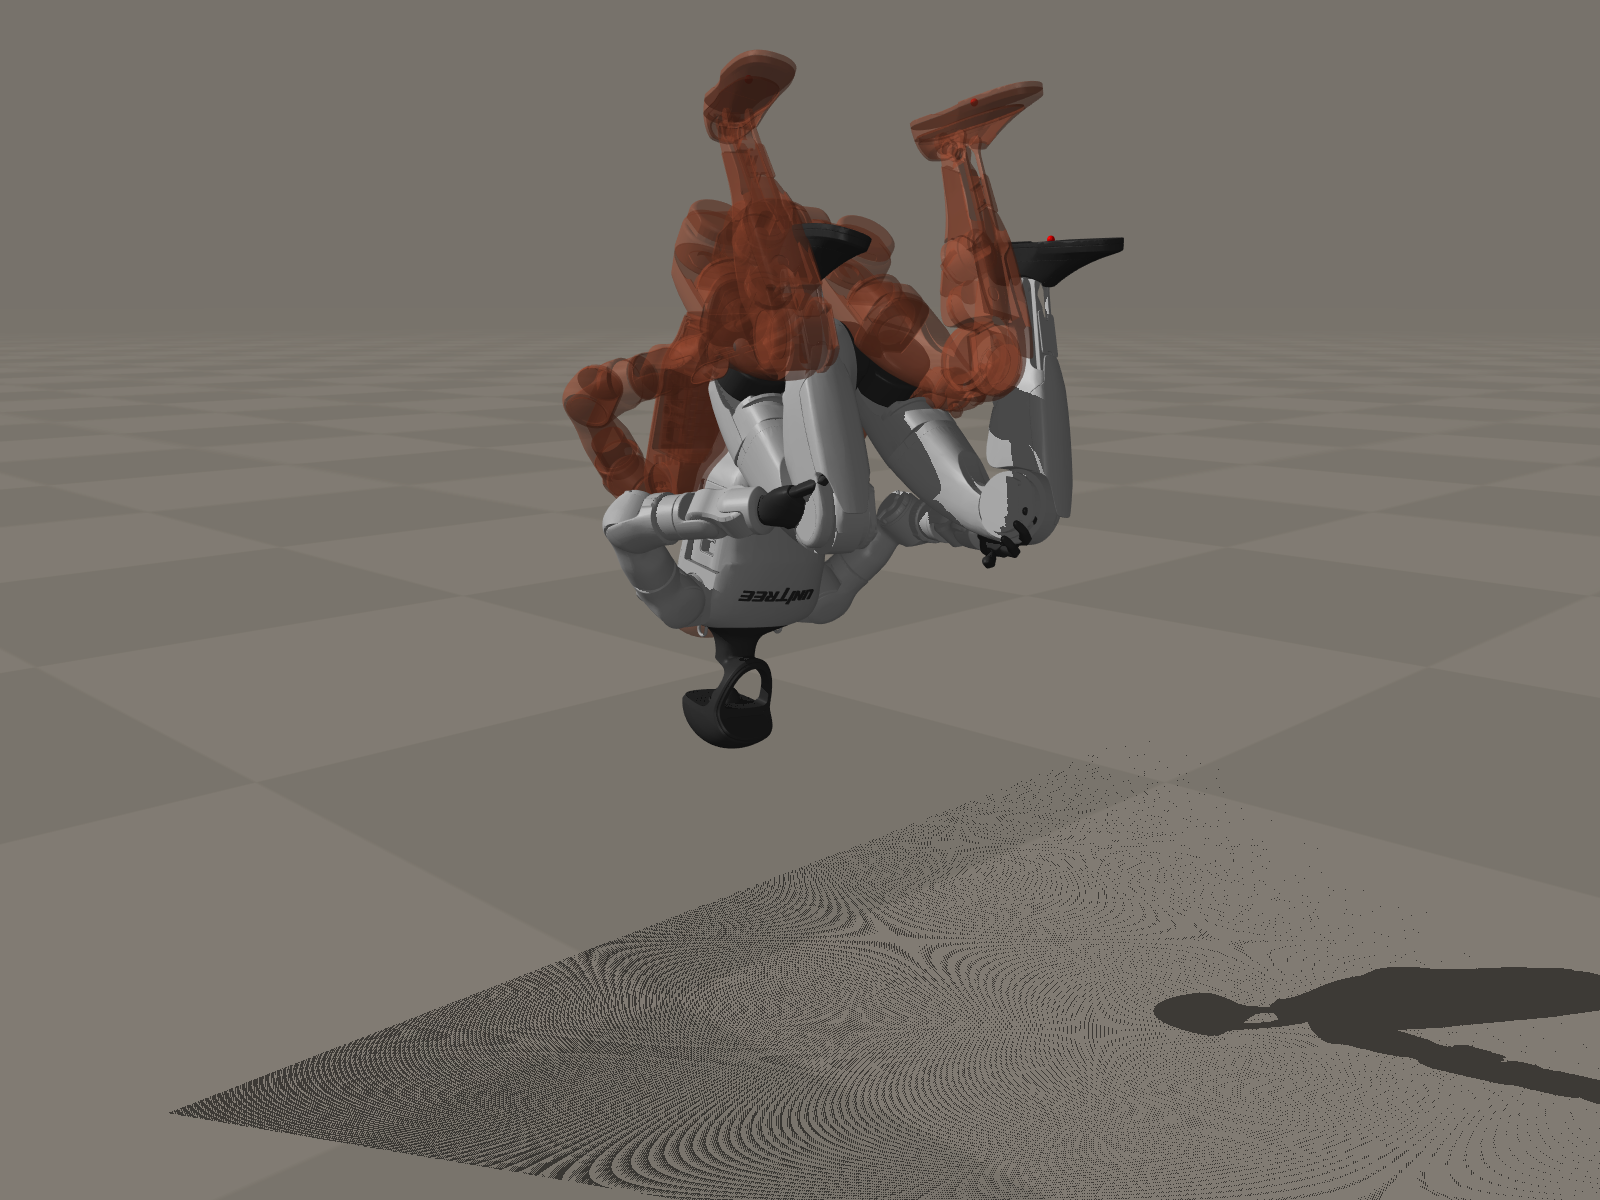
宙返りの頂点付近。半透明の赤い方がモーションキャプチャの参照姿勢、実体の方がその計画を再生したG1です。
スループット:スレッド数とサブステップ数で何倍になるか
では、窓ごとの直列処理に縛られず、シミュレーションを並べることだけに専念させたら、この機械はどこまで出るのか。ベンチマークなら、バッチの幅も並列の区間も、問題の構造ではなくこちらで決められるので、同じG1を256本並べ、他の負荷がない状態で、スレッド数だけを振りました。
env -u PYTHONPATH uv run python benchmarks/scaling.py \
examples/assets/g1.xml --assets unitree_g1 --threads 1,2,4,8,12,16,24単位はsim-substeps/sで、バッチ全体で1秒あたりに進めた物理ステップの総数です。ここでいうサブステップは、batch.step() の呼び出し1回のなかで物理積分を何回繰り返すかを指します。
スレッド数 | 1サブステップ(直列比)/10サブステップ |
|---|---|
直列 mj_step | 18,818(1.00×)/ — |
1 | 18,360(0.98×)/ 28,167 |
2 | 37,230(1.98×)/ 58,389 |
4 | 70,120(3.73×)/ 115,455 |
8 | 119,098(6.33×)/ 215,056 |
12 | 167,325(8.89×)/ 285,600 |
16 | 182,112(9.68×)/ 371,722 |
24 | 238,906(12.70×)/ 446,519 |
G1のモデルの刻み幅は10 msなので、24スレッドの238,906 sim-substeps/sは、実時間1秒のあいだに2,389秒分の物理を進めたことになり、256本を同時に、それぞれ実時間の9.3倍の速さで動かしている勘定です。
ただし、速度比のほうはそこまで信用していません。絶対値のスループットは実行のあいだで0.4%以内に収まりましたが、分母にあたる直列基準のほうは12%も動き、それだけで報告される速度比は11.4倍から12.7倍まで変わります。比は±10%、絶対値は確かな数字として読むのが妥当です。
スレッド数に対するスケーリングは、単調ではあっても線形ではありません。この機械のコアは高性能コアと高効率コアの混成で、1コアあたりのスループットが揃っておらず、速度自由度29のヒューマノイドではメモリ帯域の制約も加わるので、24論理コアで12.7倍は順当なところです。
サブステップの束ね方は、スレッド数と同じくらいスループットを左右します。呼び出しごとに10サブステップを要求すると、呼び出しごとのディスパッチとGILの往復がそのぶん薄まるため、どのスレッド数でもスループットが1.5倍を超えます(最小が1スレッドの1.53倍、最大が16スレッドの2.04倍)。
ただし、束ねるほどよいわけでもなく、制御を更新できるのは呼び出しの単位なので、10サブステップにまとめれば制御の刻みも10倍粗くなります。スループットと制御周期の交換です。
1スレッド・1サブステップの行だけは、素の mj_step のループよりわずかに遅くなっており、ここがこのライブラリの下限です。スレッドかサブステップか、どちらの形でも償却する相手がないうちは、呼び出しのディスパッチの費用だけを払うことになるからです。
サンプルコードは再利用できるか
計測ツールは、サンプルの物理を1行も書き直さずに書けましたが、その元になった300行を読み切れたかというと、それは別の話です。コードの性格は、この2つに出ます。
1つは、サンプルがimportできることです。6本すべてがエントリポイントを if __name__ == "__main__" で囲っているので、モデルの構築、クリップの読み込み、追従の計算といった関数を、そのまま読み込んで再利用でき、この検証のために書いたツールも、サンプル側の関数をそのまま読み込んでいます。
もう1つは、密度の高さです。g1_flip.py は300行ですが、その中には、箱制約つきのiLQR、IRLSで重みを付け直すGauss-Newtonのコスト展開、四元数多様体上の積分、そして非負最小二乗によるウォームスタートが入っており、最後の非負最小二乗は、さきほどの逆動力学が数十kNを出す問題への回避策です。
mjbatch以外でも出会うつまずき
mjbatchの不具合ではありませんが、実際にデバッグの時間を使わせましたし、mjbatchの外でも同じことが起きます。
mj_contactForce がエラーなしに0 Nを返す
最初に組んだ計測ループは、エラーも警告も出さないまま、バックフリップの全区間にわたって床反力0 Nを返しました。飛んでいるあいだだけなら正しい値ですが、踏み切りも着地も0 Nでした。
原因は更新の順序にあります。mj_step を呼んだ後、各部位の位置と向き(xpos、xquat)や接触の配列はステップ前の配置を記述しているので、mj_kinematics と mj_collision で更新すれば接触の幾何は直り、接触点数から飛行相を判定するには十分になります。しかし、mj_contactForce が読む接触力は接触ソルバが解いた結果なので、こちらは直りません。位置を更新する処理と力を解く処理が別々になっているために、古い値がエラーなしに返る、という型のバグです。
正しくは mj_forward を呼ぶことになり、計測ツールの1ステップは最終的にこうなりました。
data.ctrl[:] = u
mujoco.mj_step(model, data)
tau = data.actuator_force.copy()
mujoco.mj_forward(model, data)          # これが無いと grf_z は全区間 0 になる
grf_z = contact_vertical_force(model, data)
mj_forward が計算し直すのは派生する量だけなので、計測対象を動かす心配はなく、呼んだ場合と呼ばない場合で最終状態がビット単位で一致することも確認しました。
所感と今後
27.2秒で出た計画には、モデル誤差に使える余裕が残っていませんでした。だとすれば、速さが意味を持つのは、その余裕を取り直しながら何度も解き直せるときです。接触を含む全身の最適制御がノートPC1台で30秒足らずに収まるなら、パラメータを振って回すやり方は現実的な時間に入り、GPUのクラスタを確保するより先に、手元で仮説を1つ検証できます。ただし、mjbatchが速いかどうかとは別に、出てきた数字を仕分ける手間のほうは残ります。
同じG1に同じ種類の全身動作をさせる道筋は、ここで扱った最適制御のほかにもあり、グループ研究開発本部のブログには、模倣学習の枠組みでG1を動かしたBeyondMimicの解説があります。参照モーションを追従させる目的は共通で、違うのは、追従を毎回解き直すか、方策として学習しておくかです。
同時に、CPUバッチのスループットには天井があり、この機械では24論理コアで12.7倍がそれにあたるので、数万環境を並べる規模になれば、この倍率の差がそのまま学習時間の差になります。GPU側にはMJXとMuJoCo Warpがあり、同じ作者がmjlabを公開しているのもそちらの領域です。
本検証はシミュレーション上のものです。実機のUnitree G1がバックフリップを含む全身動作を公開デモで見せているのは事実ですが、メーカー自身が編集・選別した映像であり、成功率や再現性を第三者が検証した資料は確認できていません。したがって、ここで得た計画をそのまま実機に持ち込むには、トルクの余裕を取り直すところからやり直すことになります。
次に確かめたいのは、mjbatchの expand でシミュレーションごとに摩擦や質量を振ったときに、同じバックフリップの計画がどこまで成立するかです。実機に載せる前に、どのパラメータで計画が崩れるのかを知りたいからであり、27秒で1回解けるなら、摩擦を100通り振っても1時間かかりません。上限に張り付く関節が入れ替わるのかどうかは、実機に載せられるかを判断する材料になりますが、そこから先は、実機で確かめるしかありません。
おまけ:実機のG1のバックフリップ
本文の検証とは別に、オフィスで実機のUnitree G1にバックフリップをさせたときの映像を2本載せておきます。動かしているのはmjbatchで計画した軌道ではなく、別の制御です。1本目は踏み切ったあと回りきれずに転倒し、2本目は後方に一回転して足から着地しました。
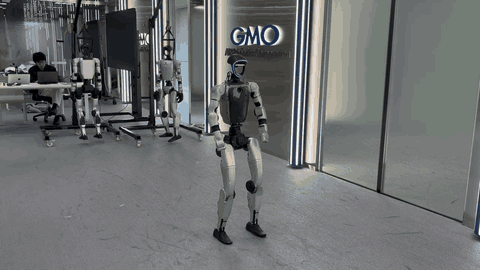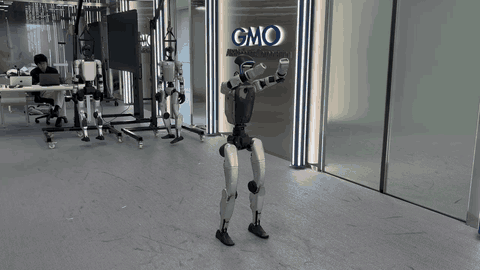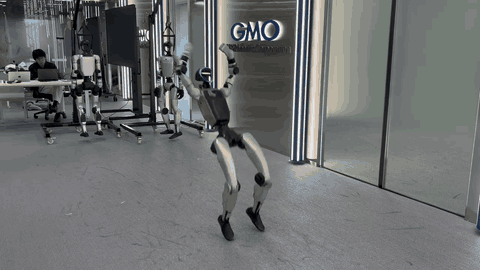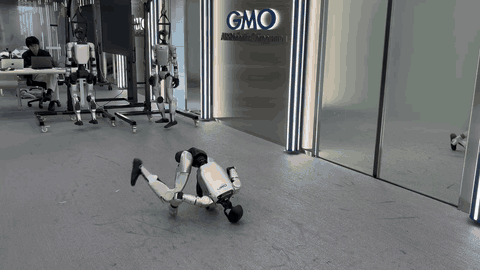
失敗した回:踏み切ったあと回りきれずに床へ倒れ込む実機のUnitree G1
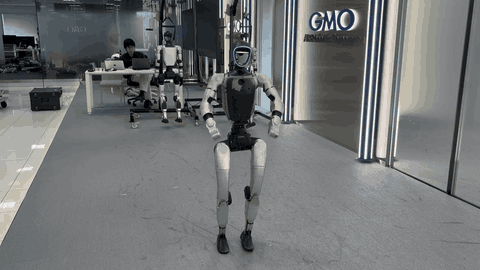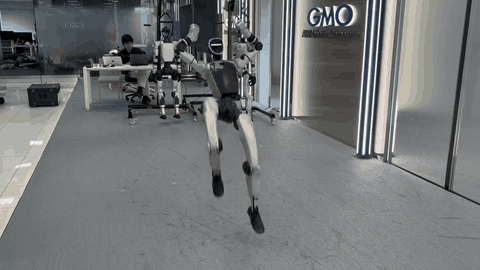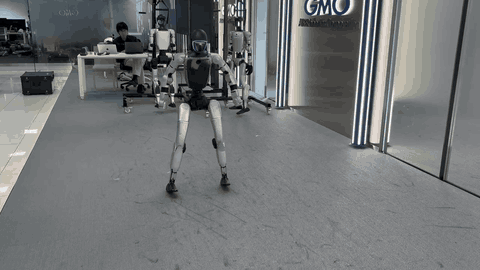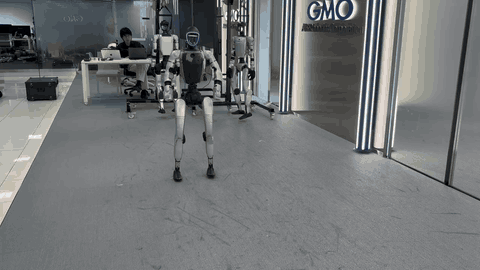
成功した回:後方に一回転して足から着地する実機のUnitree G1
参考リンク
- kevinzakka/mjbatch(Apache License 2.0)
- MuJoCo Menagerie
採用についてお知らせ
GMO AI&ロボティクス商事(GMO AIR)では、フィジカルAI・ロボティクスのリサーチエンジニア・リサーチサイエンティストを募集しています。Unitree G1などの最先端ヒューマノイド実機を用いた全身制御・動作学習の研究から、お客様先への導入という社会実装まで幅広く携われるポジションです。ヒューマノイドの全身制御やその他の要素技術、社会実装にご興味を持って頂ける方がいらっしゃいましたら、ぜひ募集職種一覧からご応募をお願いします。皆さんのご応募をお待ちしています。

