


Unitree G1の頭部にはマイクが付いています。音声対話をさせたいときはPCに別のマイクをつなぎがちですが,実はG1のマイク音声はロボットの外からでもプログラムで受け取れるようになっています。しかも,サウンドデバイスとしてではなく,ネットワーク越しに流れてくるのでした。
今回は,G1のマイク音声をPythonから受け取る方法を,その裏で使われているUDPマルチキャストやPCM音声,VADといった周辺技術とあわせて紹介したいと思います。
1.G1のマイク音声はマルチキャストで流れている
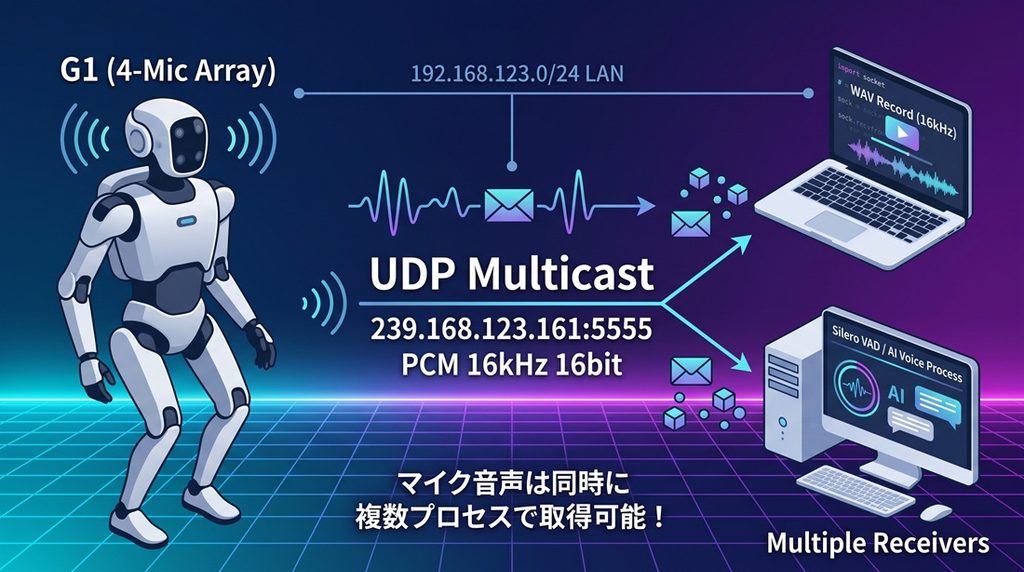
G1のマイク音声は,ロボット内部の音声サービスによってUDPマルチキャストでLAN上に流されています。ALSAやPulseAudioのデバイスとして開くわけではありません。同じネットワークにいるPCやロボット内部の開発用コンピュータから,決められたマルチキャストグループに参加すれば音声を受け取ることができます。
| 項目 | 値 |
|---|---|
| マルチキャストアドレス | 239.168.123.161 |
| ポート | 5555(UDP) |
| ロボットのネットワーク | 192.168.123.0/24(G1標準の内部ネットワーク) |
| 音声フォーマット | PCM 16bit 符号付き(リトルエンディアン)/モノラル/16kHz |
これらの値はUnitree公式SDK(unitree_sdk2)の音声サンプルにも出てくるものです。ただし,ファームウェアのバージョンによって変わる可能性もあるので,うまく受信できない場合は手元のSDKサンプルも確認してください。
2.周辺技術をおさえておく
UDPマルチキャストとは
通常のUDP通信(ユニキャスト)は送信先を1台決めて送ります。一方マルチキャストは,送信側が224.0.0.0〜239.255.255.255の範囲にある「グループアドレス」に向けて1回送るだけで,そのグループに参加している受信者全員にパケットが届く仕組みです。かなり単純化すると,「ラジオの周波数に合わせた人だけが聞ける放送」のようなイメージです。
G1がこの方式を採っているおかげで,音声認識のプロセスと録音のプロセスのように,複数のプログラムが同時に同じマイク音声を受け取れます。デバイスの取り合いを気にしなくてよいのは便利です。
受信側でやることは,次の2つだけです。
- bind:ポート5555で待ち受ける
- IP_ADD_MEMBERSHIP:OSに「このグループに参加する」と伝える(IGMP Join)
どのネットワークインターフェースで参加するか
Wi-Fiと有線LANのようにNICが複数あるPCでは,どのNICでグループに参加するかが大事です。INADDR_ANY(0.0.0.0)で参加すると,OSはデフォルトルートのNICを選びます。そのため,ロボットとつながっている有線側で参加できず,何も受信できないということがよく起こります。
ロボット側のサブネット(192.168.123.x)にある自分のIPアドレスを調べて,そのアドレスを指定して参加するのが確実です。
SO_REUSEADDRとSO_REUSEPORTの違い
同じポートを複数のプロセスで開くために,ソケットオプションを付けることがあります。ここで注意が必要なのがLinuxのSO_REUSEPORTです。このオプションはパケットを複数のソケットに振り分ける(負荷分散する)動きをすることがあり,他の受信プロセスの音声を「横取り」してしまう可能性があります。マルチキャスト受信ではSO_REUSEADDRだけにしておくのが無難です。
PCM音声とフレーム
流れてくるデータはヘッダの付いていない生のPCMです。16bitモノラルの場合,1サンプル(1フレーム)が2バイトになり,16kHzなら1秒あたり32,000バイトです。
UDPパケット1個あたりのサイズは,後段の処理が欲しいサイズと一致するとは限りません。そのため,受信データをいったんバッファにためて,必要なバイト数ずつ切り出す形にしておくと扱いやすくなります。たとえば512フレームは1,024バイトで,約32ms分です。
3.マイク音声をWAVに録音してみる
まずは一番シンプルな例です。5秒間受信してWAVファイルに保存します。標準ライブラリだけで動きます。
import socket
import struct
import wave

MCAST_GRP = "239.168.123.161"
MCAST_PORT = 5555
ROBOT_SUBNET = "192.168.123."
RATE = 16000          # 16kHz
SAMPLE_WIDTH = 2      # 16bit
DURATION_SEC = 5


def find_local_ip() -> str:
    """ロボット側サブネットにある自分の IP を調べる(見つからなければ 0.0.0.0)"""
    try:
        s = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)
        s.connect((ROBOT_SUBNET + "1", 1))  # 実際にはパケットは送られない
        ip = s.getsockname()[0]
        s.close()
        if ip.startswith(ROBOT_SUBNET):
            return ip
    except OSError:
        pass
    return "0.0.0.0"


def open_mic_socket() -> socket.socket:
    sock = socket.socket(socket.AF_INET, socket.SOCK_DGRAM, socket.IPPROTO_UDP)
    sock.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
    # SO_REUSEPORT は付けない(パケットが振り分けられてしまう可能性がある)
    sock.bind(("", MCAST_PORT))

    local_ip = find_local_ip()
    group = socket.inet_aton(MCAST_GRP)
    if local_ip == "0.0.0.0":
        mreq = struct.pack("4sL", group, socket.INADDR_ANY)
    else:
        mreq = struct.pack("4s4s", group, socket.inet_aton(local_ip))
    sock.setsockopt(socket.IPPROTO_IP, socket.IP_ADD_MEMBERSHIP, mreq)
    sock.settimeout(1.0)
    print(f"joined {MCAST_GRP}:{MCAST_PORT} on {local_ip}")
    return sock


def main():
    sock = open_mic_socket()
    target = RATE * SAMPLE_WIDTH * DURATION_SEC
    pcm = bytearray()
    while len(pcm) < target:
        try:
            data, _ = sock.recvfrom(4096)
            pcm += data
        except socket.timeout:
            print("no data... (ロボットとのネットワーク接続を確認)")
    sock.close()

    with wave.open("g1_mic.wav", "wb") as wf:
        wf.setnchannels(1)
        wf.setsampwidth(SAMPLE_WIDTH)
        wf.setframerate(RATE)
        wf.writeframes(bytes(pcm[:target]))
    print("saved g1_mic.wav")


if __name__ == "__main__":
main()ポイントはopen_mic_socket()で,bindしたあとにIP_ADD_MEMBERSHIPでグループに参加しています。保存されたg1_mic.wavを再生して声が聞こえれば成功です。
4.決まったサイズで読み出せるようにする
音声認識やVADに渡す場合は,「512フレームずつ」のように決まったサイズで読み出したいことがほとんどです。先ほどのバッファリングをクラスにまとめておくと,あとで使い回せて便利です。
from typing import Optional


class G1MicSource:
    def __init__(self):
        self.sock = open_mic_socket()   # 3章の関数を利用
        self.sock.settimeout(0.1)
        self.buffer = b""

    def read(self, frames: int) -> Optional[bytes]:
        """frames 分(frames * 2 バイト)の PCM を返す。まだ届いていなければ None"""
        need = frames * 2
        while len(self.buffer) < need:
            try:
                data, _ = self.sock.recvfrom(4096)
                self.buffer += data
            except socket.timeout:
                return None
        chunk, self.buffer = self.buffer[:need], self.buffer[need:]
return chunk受信にタイムアウトを設定してNoneを返すようにしているので,asyncioのイベントループからrun_in_executorで呼ぶ場合にも処理が止まりにくくなります。
5.受信しながらリアルタイムに録音する
3章では決まった秒数を受信してからまとめて保存しました。長時間録音する場合は,受信したそばからファイルに書き込むほうがメモリを使わずに済みます。Pythonのwaveモジュールはwriteframes()を呼ぶたびにデータを追記し,ヘッダのデータ長もその都度更新してくれます。そのため,Ctrl+Cで止めるまで録音し続ける仕組みが簡単に作れます。
import datetime
import wave

import numpy as np

CHUNK = 512
RATE = 16000


def record_forever():
    mic = G1MicSource()
    filename = datetime.datetime.now().strftime("g1_%Y%m%d_%H%M%S.wav")
    total_frames = 0

    with wave.open(filename, "wb") as wf:
        wf.setnchannels(1)
        wf.setsampwidth(2)
        wf.setframerate(RATE)
        print(f"recording to {filename} (Ctrl+C で停止)")
        try:
            while True:
                chunk = mic.read(CHUNK)
                if chunk is None:
                    continue
                wf.writeframes(chunk)  # 受信したそばから追記
                total_frames += CHUNK

                # 簡易レベルメーター(音が届いているかの確認用)
                peak = np.abs(np.frombuffer(chunk, dtype=np.int16)).max() / 32768
                bar = "#" * int(peak * 40)
                print(f"\r{total_frames / RATE:7.1f} sec |{bar:<40}|", end="")
        except KeyboardInterrupt:
            pass
    print(f"\nsaved {filename}")


if __name__ == "__main__":
    record_forever()
簡易的なレベルメーターも表示しているので,マイクに音が届いているかを目で確認できます。また,マルチキャストなので,ロボット上で別のアプリがマイクを使っていても,録音用のプロセスをもう1つ立てれば並行して記録できます。動作ログとして会話を残したり,VADのしきい値調整用のテスト音声を集めたりするのに使いやすいと思います。
6.VADで話している区間だけを取り出す
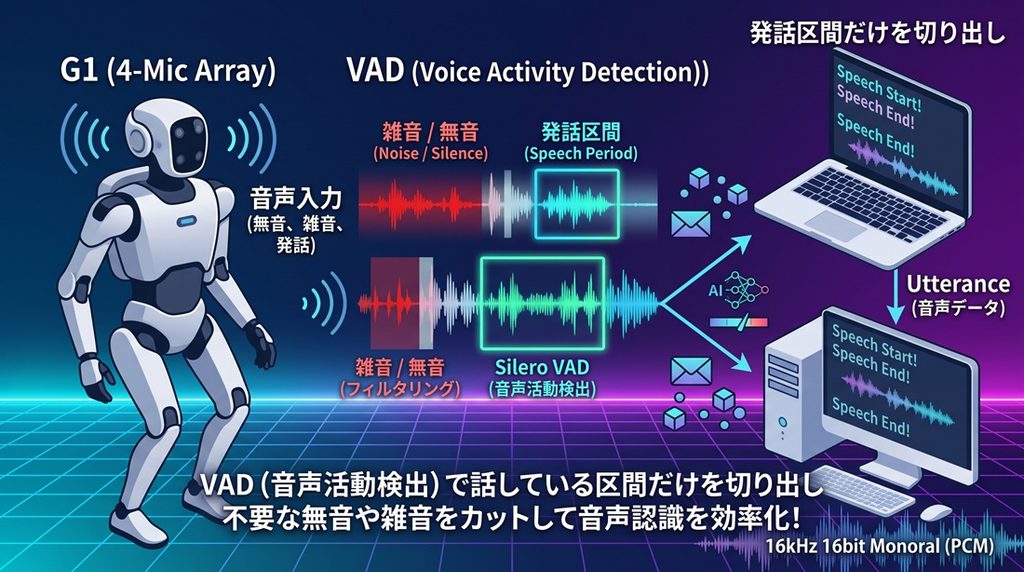
マイクからは無音や雑音も絶えず流れてきます。音声認識APIに全部送るとコストも遅延も増えてしまうので,VAD(Voice Activity Detection:発話区間検出)で人が話している部分だけを切り出すのが定番です。
ここでは,軽量で精度の良いSilero VADを使います。Silero VADは16kHzの場合512サンプル単位で「発話らしさ」の確率を返してくれるので,G1のマイク音声とそのまま組み合わせることができます。
# pip install silero-vad numpy torch
import time
import numpy as np
import torch
from silero_vad import load_silero_vad

CHUNK = 512
THRESHOLD = 0.4        # 発話とみなす確率
SILENCE_SEC = 0.7      # これだけ無音が続いたら発話終了


def main():
    model = load_silero_vad()
    mic = G1MicSource()
    buf, speaking, last_voice = [], False, 0.0

    while True:
        chunk = mic.read(CHUNK)
        if chunk is None:
            continue

        audio = np.frombuffer(chunk, dtype=np.int16).astype(np.float32) / 32768.0
        with torch.inference_mode():
            prob = model(torch.from_numpy(audio), 16000).item()

        now = time.time()
        if prob >= THRESHOLD:
            if not speaking:
                print("speech start")
            speaking, last_voice = True, now

        if speaking:
            buf.append(chunk)
            if now - last_voice > SILENCE_SEC:
                utterance = b"".join(buf)
                print(f"speech end: {len(utterance) / 32000:.2f} sec")
                # ここで音声認識 API などに utterance を渡す
                buf, speaking = [], False
しきい値や無音判定の時間は,会場の騒がしさや話者との距離によって最適な値が変わります。実際の環境で調整する必要があります。
7.ハマりどころ
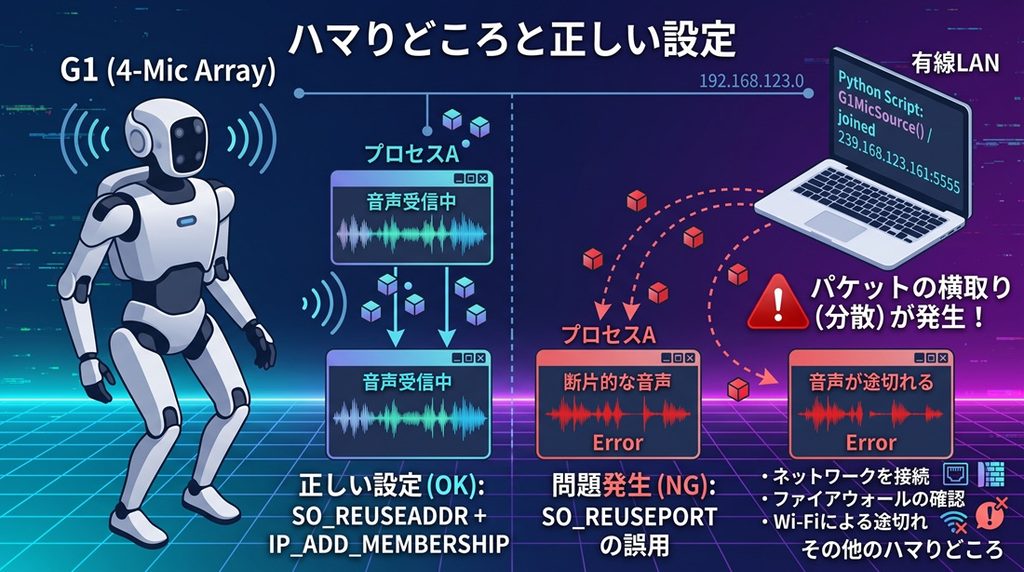
- 何も受信できない:PCがロボットのネットワーク(
192.168.123.x)に有線でつながっているか確認してください。IPを固定で設定している場合は,サブネットが合っているかも確認が必要です。 - Windows/macOSのファイアウォール:受信方向のUDP 5555がブロックされていることがあります。
- ロボット自身の発話を拾ってしまう:スピーカーとマイクが近いので,ロボットが話している間はその声もマイクに入ります。音声認識やVADと組み合わせると,ロボットが自分の声に反応してしまうことがあります。ロボットの発話中に受信した音声は処理に回さないといった工夫が必要です。
- Wi-Fi経由だと途切れる:マルチキャストは無線LANと相性が悪く,パケットロスや遅延が起きやすいです。有線接続か,ロボットの開発用コンピュータ上で実行するのがおすすめです。
8.まとめ
G1のマイク音声は239.168.123.161:5555にUDPマルチキャストで流れていて,bindとIP_ADD_MEMBERSHIPだけで受け取ることができます。データは16kHz/16bit/モノラルの生PCMなので,バッファリングして決まったサイズで切り出すと扱いやすくなります。受信したそばからWAVに追記すればリアルタイム録音ができ,Silero VADと組み合わせれば発話区間の切り出しもできます。
外付けのマイクを用意しなくても,ロボット自身の「耳」をそのまま使えるのは良いところですね。マルチキャストなので,既存のアプリを動かしたまま録音や解析を試せるのも便利です。G1で音声インタラクションを作るときの参考になればと思います。
参考
GMOインターネットグループ株式会社 グループ研究開発本部 AI研究開発室では,フィジカルAI・ロボティクスのリサーチエンジニア・リサーチサイエンティストを募集しています。ヒューマノイドの全身制御やその他の要素技術,社会実装にご興味を持って頂ける方がいらっしゃいましたら、ぜひ募集職種一覧からご応募をお願いします。皆さんのご応募をお待ちしています。

